Publicado el — Deja un comentario

El camino hacia la superinteligencia médica

Ilustración abstracta con una espiral punteada amarilla que recuerda a una hélice de ADN, superpuesta sobre cuadros texturizados en tonos de rosa, rojo, crema y púrpura, con patrones y degradados variados.

El camino hacia la superinteligencia médica

Por: Dominic King y Harsha Nori.

El equipo de IA de Microsoft comparte investigaciones que demuestran cómo la IA puede investigar y resolver de manera secuencial, los desafíos de diagnóstico más complejos de la medicina, casos que los médicos expertos luchan por responder.

Comparados con los registros de casos del mundo real publicados cada semana en el New England Journal of Medicine, mostramos que el Microsoft AI Diagnostic Orchestrator (MAI-DxO) diagnostica de manera correcta hasta el 85% de los procedimientos de casos de NEJM, una tasa más de cuatro veces superior a la de un grupo de médicos experimentados. MAI-DxO también llega al diagnóstico correcto de manera más rentable que los médicos.

—

A medida que la demanda de atención médica continúa su crecimiento, los costos aumentan a un ritmo insostenible y miles de millones de personas enfrentan múltiples barreras para una mejor salud, incluidos diagnósticos inexactos y tardíos. Cada vez más, las personas recurren a las herramientas digitales para obtener asesoramiento y apoyo médico. En los productos de consumo de IA de Microsoft, como Bing y Copilot, vemos más de 50 millones de sesiones relacionadas con la salud todos los días. Desde una consulta por primera vez sobre el dolor de rodilla hasta una búsqueda nocturna de una clínica de atención urgente, los motores de búsqueda y los compañeros de IA se convierten con rapidez en la nueva primera línea de la atención médica.

Queremos hacer más para ayudar, y creemos que la IA generativa puede ser transformadora. Por eso, a finales de 2024, lanzamos un esfuerzo dedicado a la salud del consumidor en Microsoft AI, dirigido por médicos, diseñadores, ingenieros y científicos de IA. Este esfuerzo complementa las iniciativas de salud más amplias de Microsoft y se basa en nuestro compromiso de larga data con la asociación y la innovación. Las soluciones existentes incluyen RAD-DINO,  que ayuda a acelerar y mejorar los flujos de trabajo de radiología, y Microsoft Dragon Copilot, nuestro asistente pionero de IA de voz para médicos.

Para que la IA marque la diferencia, tanto los médicos como los pacientes deben poder confiar en su rendimiento. Ahí es donde entran en juego nuestros nuevos puntos de referencia y el orquestador de IA.

Desafíos y puntos de referencia de casos médicos

Para ejercer la medicina en los Estados Unidos, los médicos deben aprobar el Examen de Licencia Médica de los Estados Unidos (USMLE, por sus siglas en inglés), una evaluación rigurosa y estandarizada del conocimiento clínico y la toma de decisiones. Las preguntas USMLE se encuentran entre los primeros puntos de referencia utilizados para evaluar los sistemas de IA en medicina, ya que ofrecen una forma estructurada de comparar el rendimiento de los modelos, tanto entre sí como con los clínicos humanos.

En solo tres años, la IA generativa ha avanzado hasta el punto de obtener puntuaciones casi perfectas en el USMLE y exámenes similares. Pero estas pruebas se basan en su mayoría en preguntas de opción múltiple, que favorecen la memorización sobre la comprensión profunda. Al reducir la medicina a respuestas únicas a preguntas de opción múltiple, estos puntos de referencia exageran la aparente competencia de los sistemas de IA y oscurecen sus limitaciones.

En Microsoft AI, trabajamos para avanzar y evaluar las capacidades de razonamiento clínico. Para ir más allá de las limitaciones de las preguntas de opción múltiple, nos hemos centrado en el diagnóstico secuencial, una piedra angular de la toma de decisiones médicas en el mundo real. En este proceso, un médico comienza con una presentación inicial para el paciente y luego selecciona de manera iterativa preguntas y pruebas diagnósticas para llegar a un diagnóstico final. Por ejemplo, un paciente que presenta tos y fiebre puede llevar al médico a ordenar y revisar análisis de sangre y una radiografía de tórax antes de sentirse seguro de diagnosticar neumonía.

Cada semana, el New England Journal of Medicine (NEJM), una de las revistas médicas más importantes del mundo, publica un registro de caso del Hospital General de Massachusetts, que presenta el proceso de atención de un paciente en un formato narrativo detallado. Estos casos se encuentran entre los más complejos diagnósticos y de una gran exigencia a nivel intelectual, de la medicina clínica, ya que a menudo requieren múltiples especialistas y pruebas diagnósticas para llegar a un diagnóstico definitivo.

¿Cómo se comporta la IA? Para responder a esto, creamos desafíos de casos interactivos extraídos de la serie de casos de NEJM, lo que llamamos el Punto de Referencia de Diagnóstico Secuencial (SD Bench). Este punto de referencia transforma 304 casos recientes de NEJM en encuentros de diagnóstico escalonados en los que los modelos, o los médicos humanos, pueden hacer preguntas y solicitar pruebas de forma iterativa. A medida que se dispone de nueva información, el modelo o el clínico actualizan su razonamiento, acercándose de manera gradual a un diagnóstico final. Este diagnóstico puede compararse con el resultado de referencia publicado en el NEJM.

Cada investigación solicitada también incurre en un costo (virtual), que refleja los gastos de atención médica del mundo real. Esto nos permite evaluar el rendimiento en dos dimensiones clave: la precisión del diagnóstico y el gasto de recursos. Pueden ver cómo un sistema de IA avanza a través de uno de estos desafíos en este breve video.

Tutorial de cómo MAI-DxO trabaja a través de un caso para llegar a un diagnóstico.

Cómo llegar a un diagnóstico correcto

Evaluamos un conjunto completo de modelos de IA generativa de frontera frente a los 304 casos de NEJM. Los modelos de base probados incluyeron GPT, Llama, Claude, Gemini, Grok y DeepSeek.

Más allá de la evaluación comparativa de referencia, también desarrollamos Microsoft AI Diagnostic Orchestrator (MAI-DxO), un sistema diseñado para emular un panel virtual de médicos con diversos enfoques de diagnóstico que colaboran para resolver casos de diagnóstico. Creemos que la orquestación de múltiples modelos de lenguaje será fundamental para gestionar flujos de trabajo clínicos complejos. Los orquestadores pueden integrar diversas fuentes de datos de forma más eficaz que los modelos individuales, al tiempo que mejoran la seguridad, la transparencia y la adaptabilidad en respuesta a las necesidades médicas cambiantes. Este enfoque independiente del modelo promueve la auditabilidad y la resiliencia, atributos clave en entornos clínicos de alto riesgo y rápida evolución.
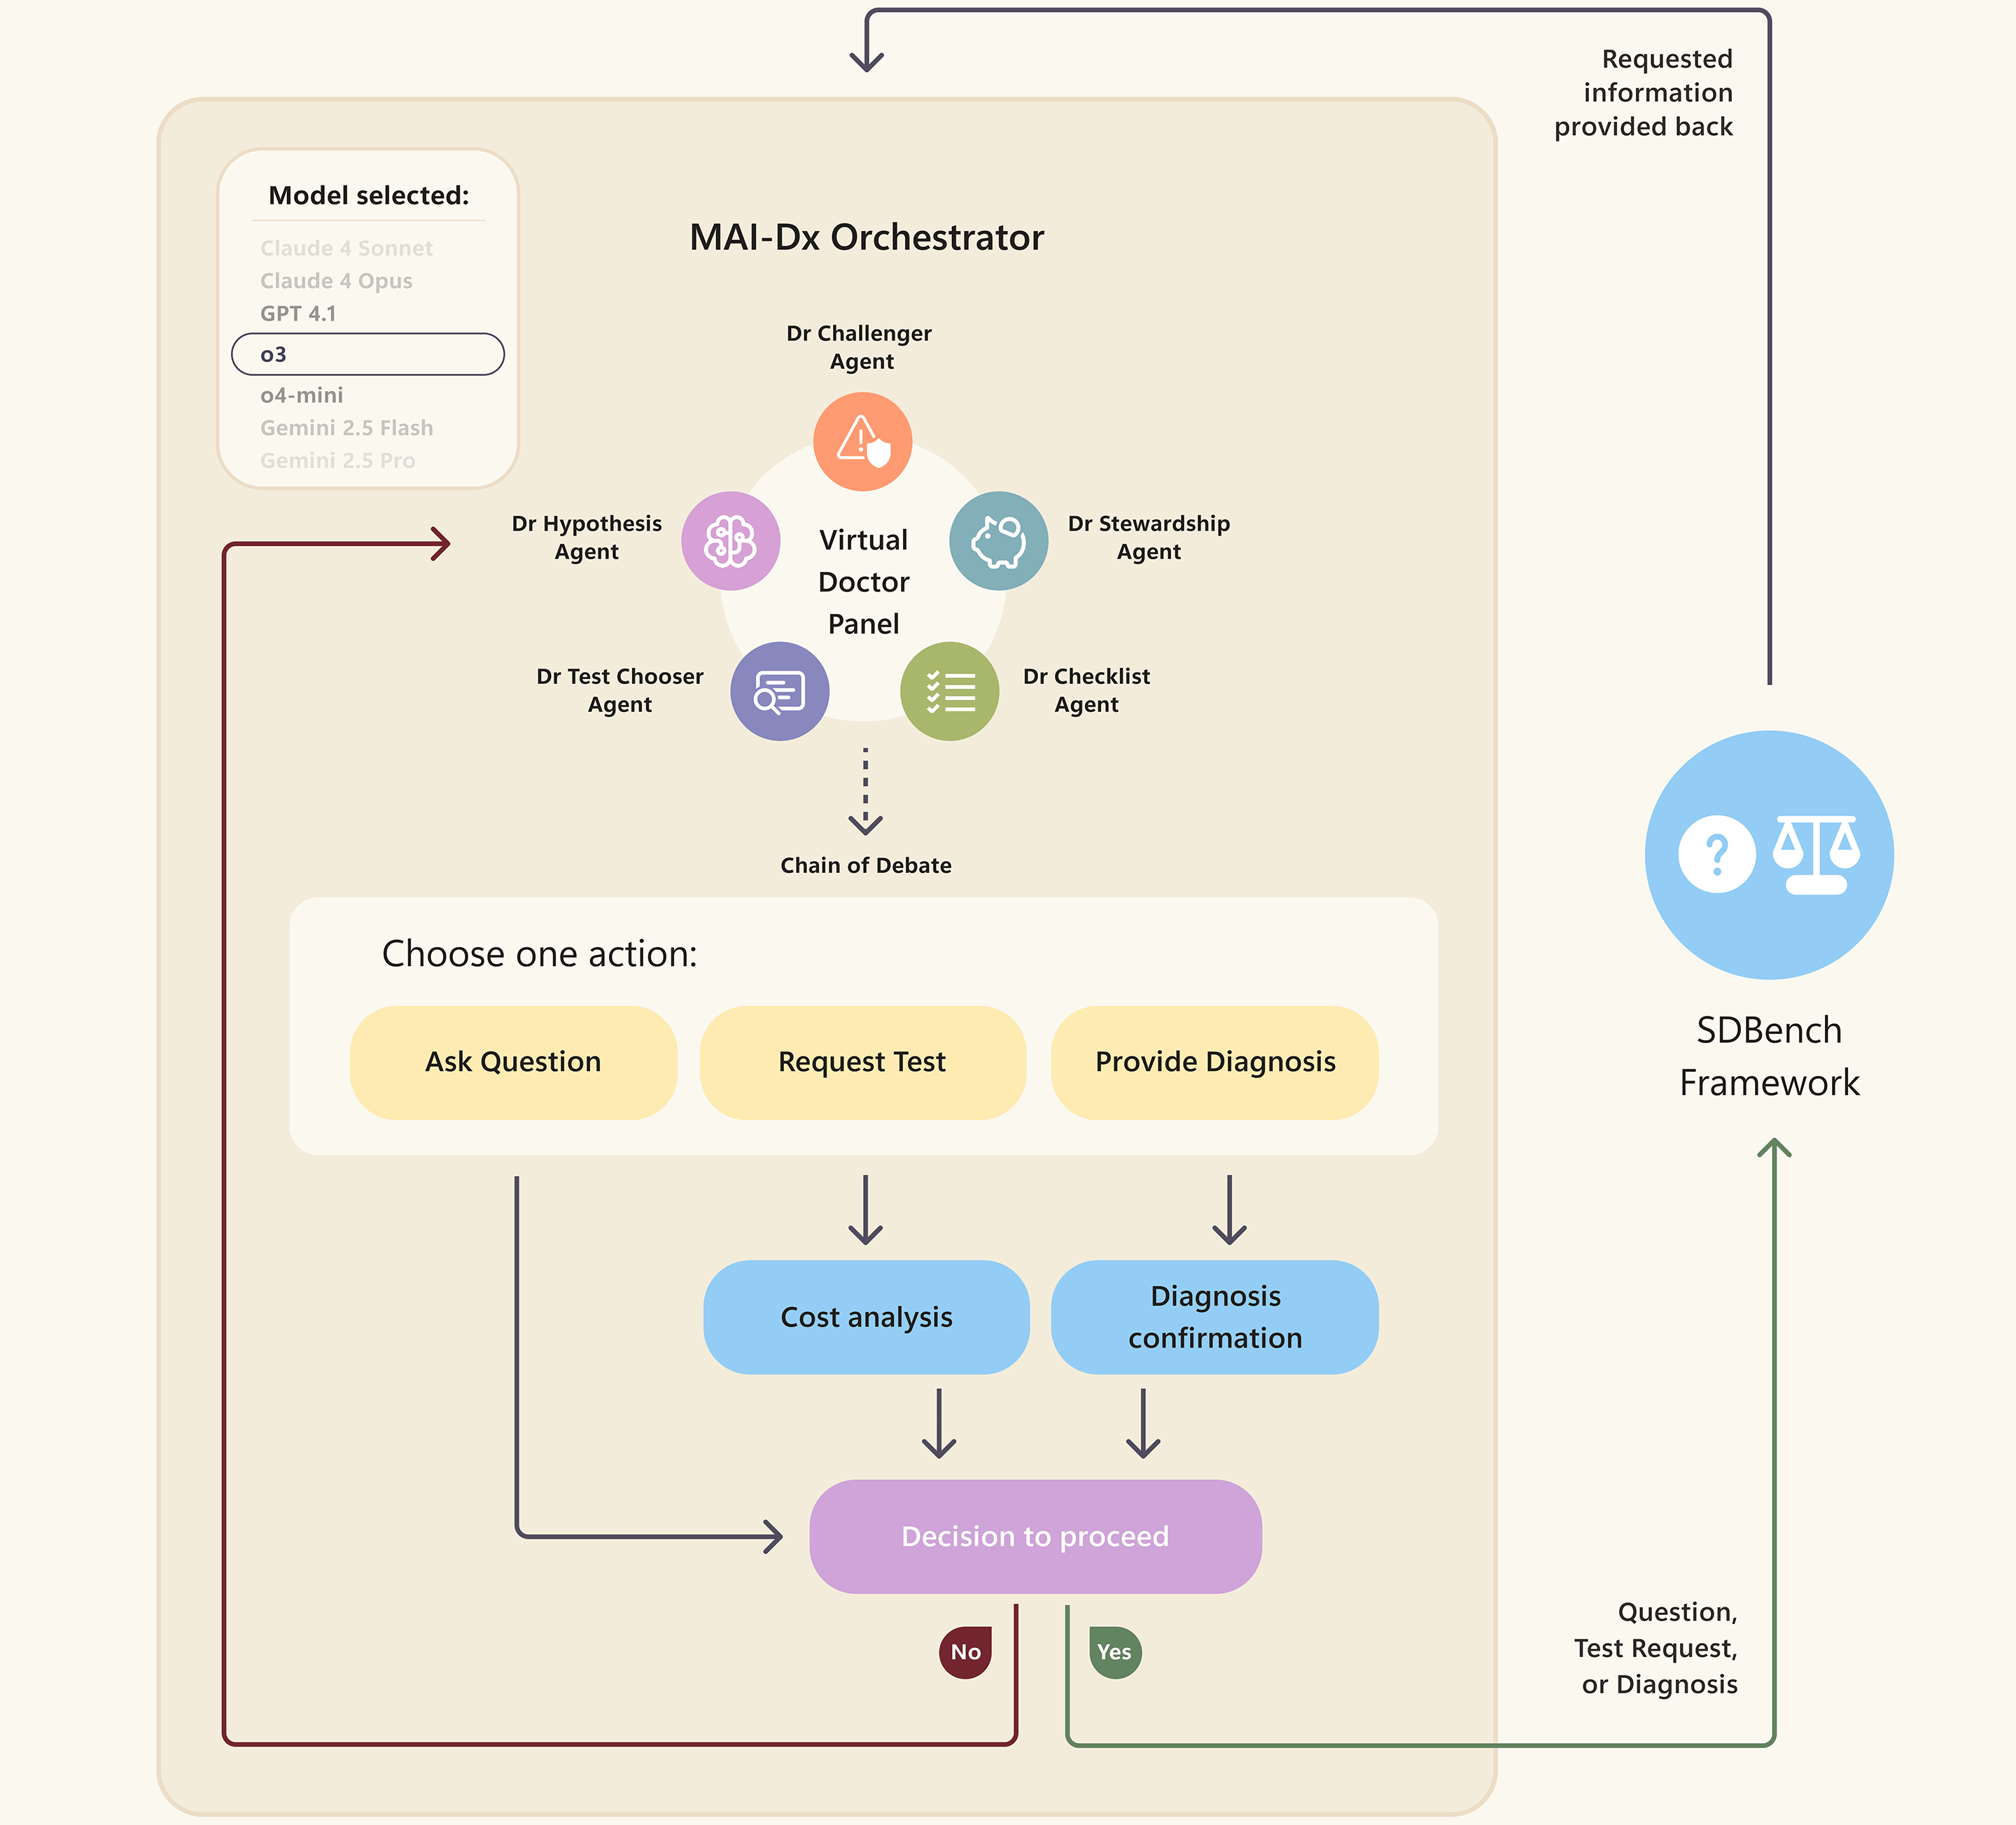
Un diagrama de flujo que muestra un proceso de diagnóstico médico impulsado por inteligencia artificial con agentes (por ejemplo, Hipótesis, Doctor, Análisis de Costos), un panel de decisiones y el marco SD Bench para manejar preguntas, solicitudes de pruebas y diagnósticos.
El MAI-Dx Orchestrator convierte cualquier modelo de lenguaje en un panel virtual de médicos: puede hacer preguntas de seguimiento, solicitar pruebas o entregar un diagnóstico, luego ejecutar una verificación de costos y verificar su propio razonamiento antes de decidir si continuar.

MAI-DxO aumentó el rendimiento de diagnóstico de todos los modelos que probamos. La configuración con mejor rendimiento fue MAI-DxO combinada con o3 de OpenAI, que resolvió de manera correcta el 85,5% de los casos de referencia de NEJM. A modo de comparación, también evaluamos a 21 médicos en ejercicio de los EE. UU. y el Reino Unido, cada uno con 5-20 años de experiencia clínica. En las mismas tareas, estos expertos lograron una precisión media del 20% en los casos completados.

MAI-DxO es configurable, lo que le permite operar dentro de las restricciones de costo definidas. Esto permite una exploración explícita de las compensaciones costo-valor inherentes a la toma de decisiones diagnósticas. Sin estas limitaciones, un sistema de IA podría ordenar por defecto todas las pruebas posibles, sin importar el costo, la incomodidad del paciente o los retrasos en la atención. Es importante destacar que descubrimos que MAI-DxO brindó una mayor precisión diagnóstica y menores costos generales de pruebas que los médicos o cualquier modelo de fundación individual probado.   
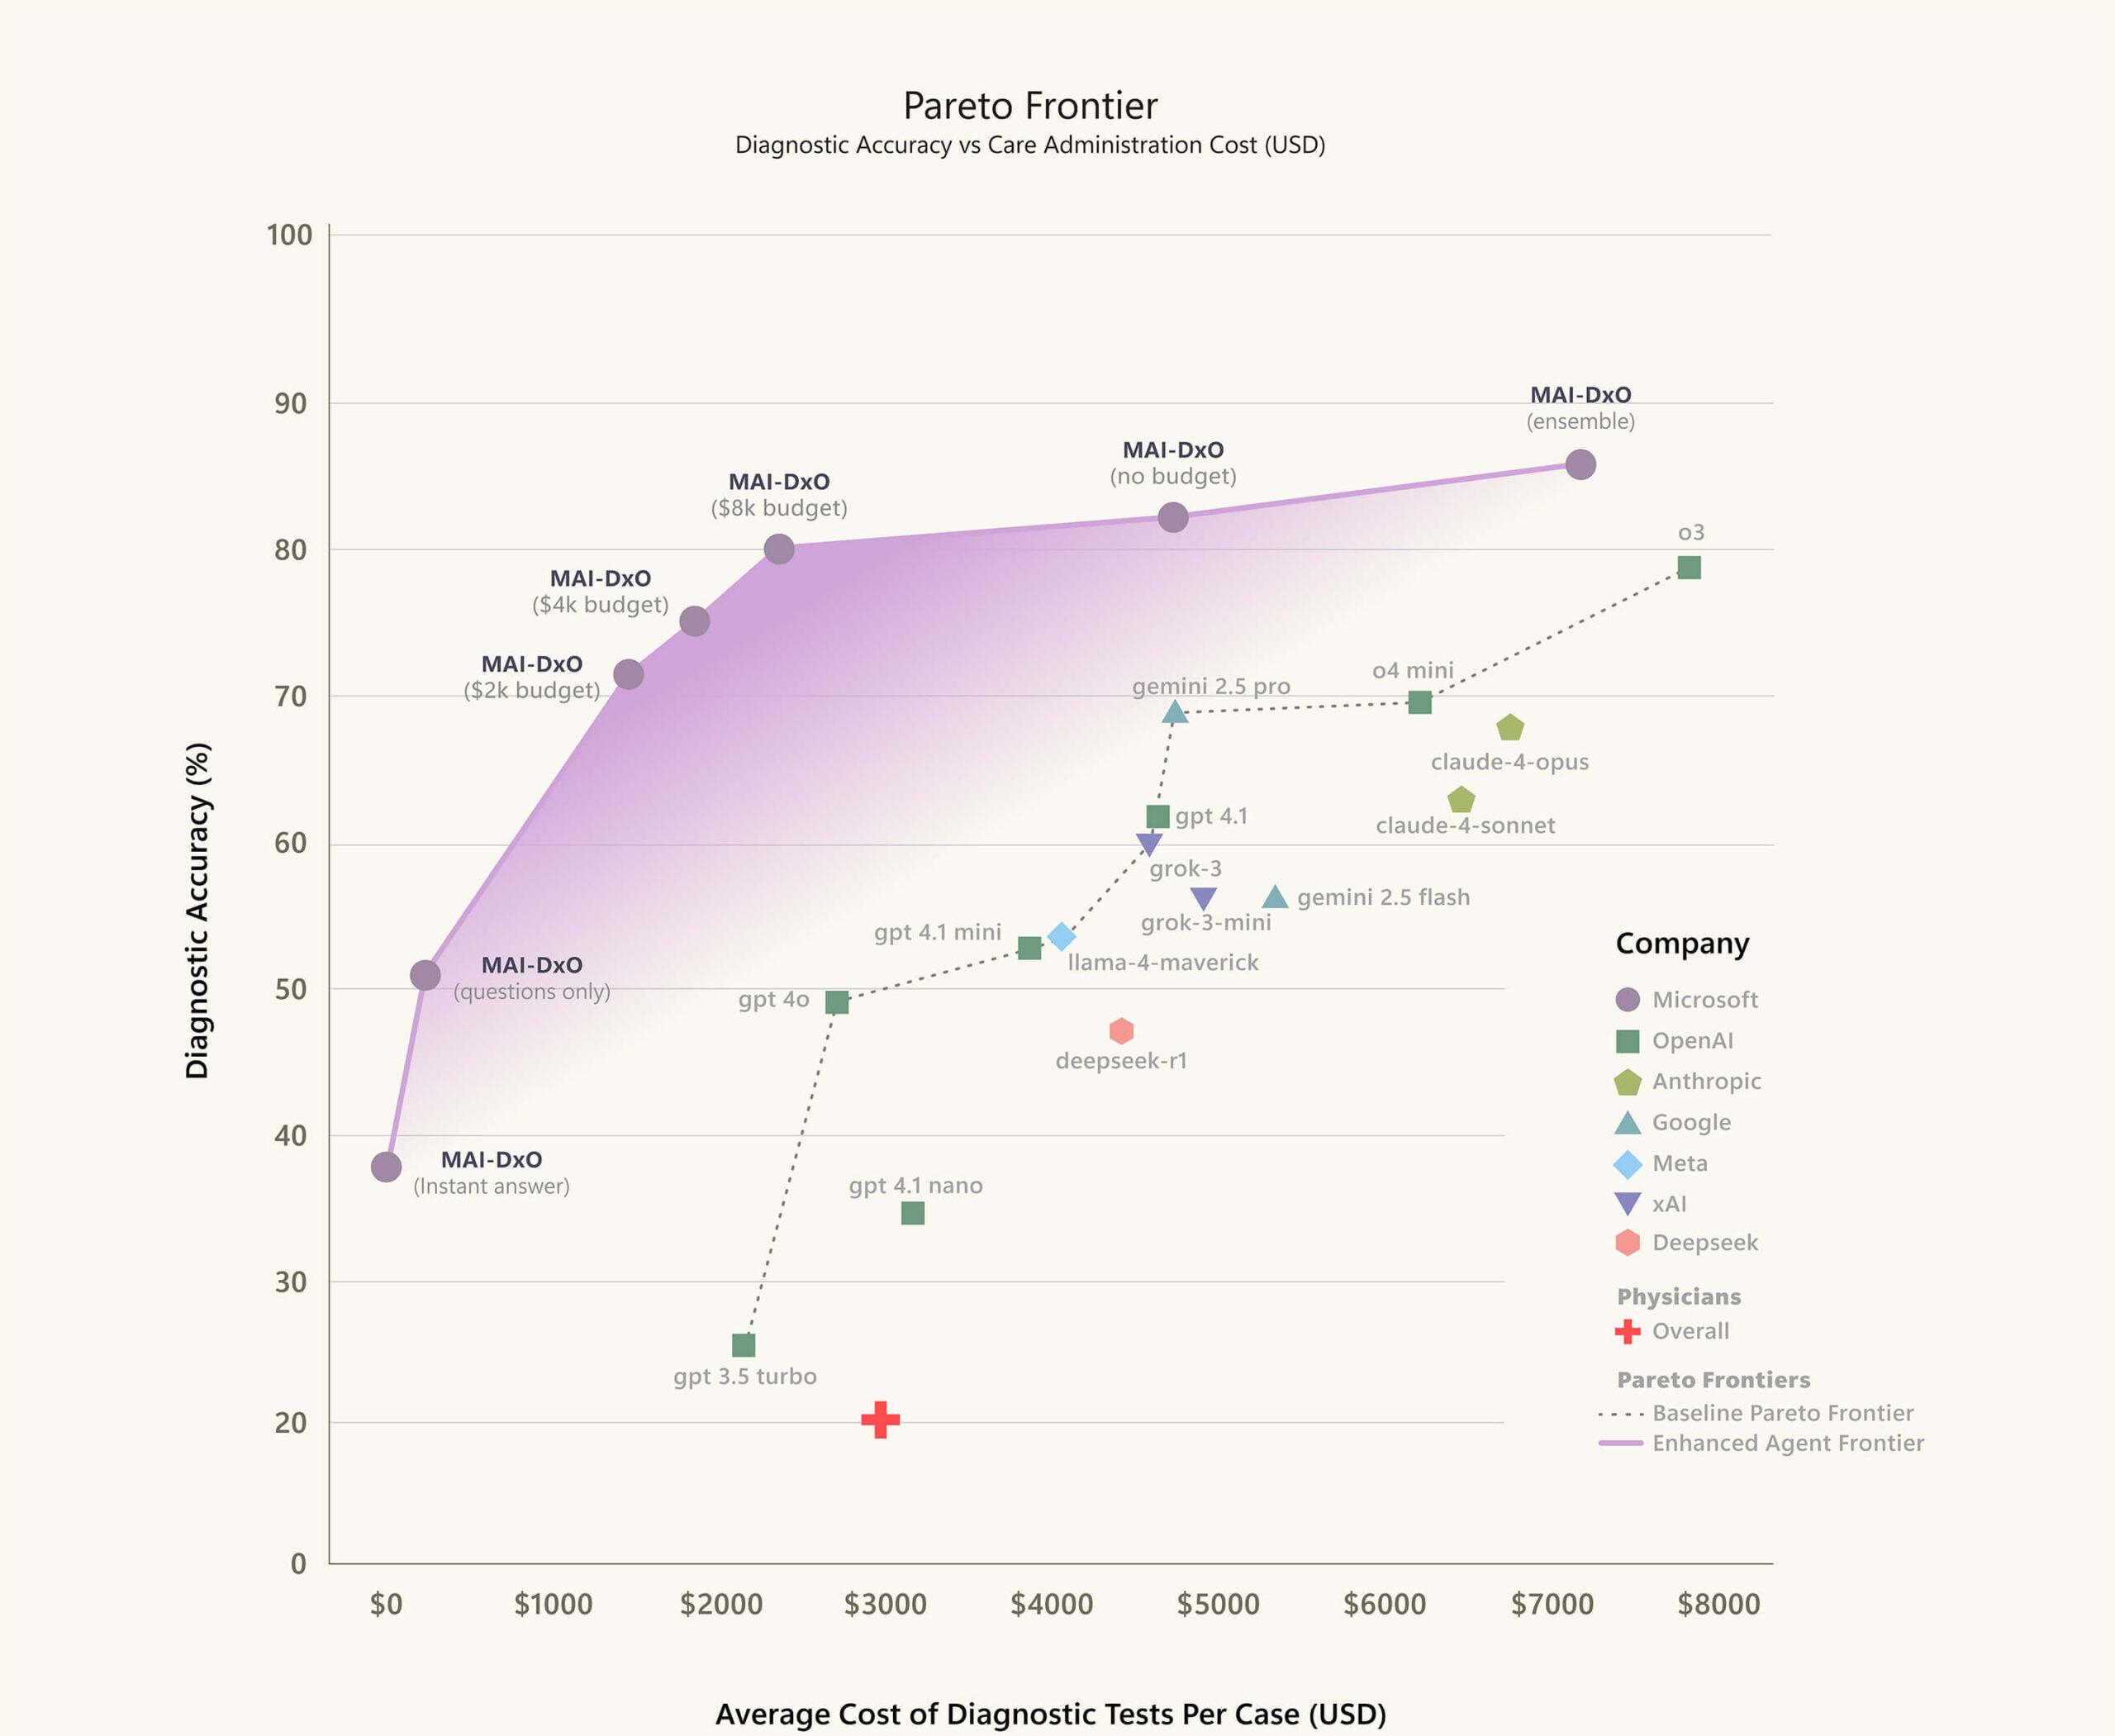
Un diagrama de dispersión compara modelos de diagnóstico con inteligencia artificial según su precisión (eje y) y el costo por caso (eje x). La región sombreada en púrpura resalta la frontera de Pareto. Los íconos representan empresas; una estrella marca la referencia del médico. Una mayor precisión se representa hacia arriba.
Comparación de agentes de diagnóstico impulsados por IA por precisión y costo promedio de las pruebas de diagnóstico por caso. Los agentes con mejor rendimiento aparecen en el cuadrante superior izquierdo, lo que refleja una mayor precisión y un menor costo. La línea punteada inferior representa el rango de rendimiento de los mejores modelos de cimentación individuales. La línea púrpura traza el rendimiento de MAI-DxO en diferentes configuraciones. La cruz roja indica el rendimiento medio de 21 médicos en ejercicio.

¿Qué sigue?

Los médicos suelen caracterizarse por la amplitud o profundidad de su experiencia. Los generalistas, al igual que los médicos de familia, manejan una amplia gama de afecciones a través de las edades y los sistemas de órganos. Los especialistas, como los reumatólogos, se centran a profundidad en un solo sistema, área de enfermedad o incluso afección. Sin embargo, ningún médico por sí solo puede abarcar toda la complejidad de la serie de casos de NEJM. La IA, por otro lado, no se enfrenta a esta disyuntiva. Puede combinar la amplitud y la profundidad de la experiencia, para demostrar capacidades de razonamiento clínico que, en muchos aspectos del razonamiento clínico, superan las de cualquier médico individual.

Este tipo de razonamiento tiene el potencial de remodelar la atención médica. La IA podría empoderar a los pacientes para autogestionar los aspectos rutinarios de la atención y equipar a los médicos con apoyo avanzado para la toma de decisiones en casos complejos. Nuestros hallazgos también sugieren que la IA reduce los costos innecesarios de atención médica. El gasto sanitario de EE.UU. se acerca al 20% del PIB de EE.UU., y se estima que hasta el 25% de ese gasto se desperdicia, ya que tiene poca influencia en los resultados de los pacientes.

Por supuesto, nuestra investigación tiene importantes limitaciones. Aunque MAI-DxO sobresale en el abordaje de los desafíos de diagnóstico más complejos, se necesitan más pruebas para evaluar su rendimiento en presentaciones más comunes y cotidianas. Los médicos de nuestro estudio trabajaron sin acceso a colegas, libros de texto o incluso IA generativa, que pueden formar parte de su práctica clínica normal, para permitir una comparación justa con el rendimiento humano bruto.

Un aspecto novedoso de este trabajo es su atención al costo. Si bien los costos de salud en el mundo real varían según las zonas geográficas y los sistemas, e incluyen muchos factores posteriores que no tenemos en cuenta, aplicamos una metodología coherente en todos los agentes y médicos evaluados para ayudar a cuantificar las compensaciones de alto nivel entre la precisión del diagnóstico y el uso de recursos.

Para nosotros, este es solo el primer paso. Estamos energizados por las oportunidades que tenemos por delante. Quedan retos importantes por delante antes de que la IA generativa pueda desplegarse de forma segura y responsable en la sanidad. Necesitamos pruebas extraídas de entornos clínicos reales, junto con marcos regulatorios y de gobernanza adecuados para garantizar la fiabilidad, la seguridad y la eficacia. Es por eso que nos asociamos con organizaciones de salud líderes para probar y validar de manera rigurosa estos enfoques, un paso esencial antes de cualquier implementación más amplia.

Junto con nuestros socios, creemos con firmeza que el futuro de la atención médica se moldeará a través de aumentar la experiencia humana y la empatía con el poder de la inteligencia artificial. Estamos entusiasmados de dar los próximos pasos para hacer realidad esa visión.

—

Más información:
SD Bench y MAI-DxO son solo demostraciones de investigación y en la actualidad no están disponibles como puntos de referencia públicos u orquestadores. Pueden encontrar más detalles sobre la metodología subyacente y los resultados en un artículo preimpreso publicado junto con este blog. Estamos en el proceso de presentar este trabajo para una revisión externa por pares y trabajamos de manera activa con socios para explorar el potencial de lanzar SDBench como un punto de referencia público.

Agradecimientos:
Agradecemos a NEJM Group por el permiso para utilizar los casos de NEJM en la investigación reportada en esta publicación de blog. La investigación descrita aquí se ha beneficiado de las ideas de muchas personas. Agradecemos a los autores nombrados en el artículo de arXiv y al equipo más amplio de MAI. También agradecemos a otros colegas tanto dentro como fuera de Microsoft por compartir sus ideas, incluidos Bryan Bunning, Nando de Freitas, Andrija Milicevic, Hoifung Poon, David Rhew, Karén Simonyan, Eric Topol y Jim Weinstein. Gianluca Fontana y Kevin Hawkins (Prova Health) brindaron apoyo en la sección de economía y resultados de la salud.

Ver Publicación (en inglés)

—Preguntas y respuestas

¿Es seguro usar esta IA para la atención médica?
El trabajo presentado aquí aún no está aprobado para uso clínico y solo se aprobaría después de rigurosas pruebas de seguridad, validación clínica y revisiones regulatorias. Por ahora, esto representa una investigación inicial emocionante. En el corazón de cualquier plan para implementar esta tecnología en el mundo real se encuentra nuestro compromiso con la seguridad, la confianza y la calidad, para asegurar que cualquier solución de atención médica esté fundamentada a nivel clínico, diseñada de manera ética y comunicada de manera transparente.

¿Reemplazará la IA a los médicos?
Si bien la IA se ha comenzado a convertir en una herramienta poderosa en la atención médica, nuestro equipo de médicos en ejercicio cree que la IA representa un complemento para los médicos y otros profesionales de la salud. Si bien esta tecnología avanza con rapidez, sus funciones clínicas son mucho más amplias que sólo hacer un diagnóstico. Necesitan navegar por la ambigüedad y generar confianza con los pacientes y sus familias de una manera que la IA no está configurada para hacer. Creemos que las funciones clínicas evolucionarán con la IA, lo que dará a los médicos la capacidad de automatizar las tareas rutinarias, identificar enfermedades antes, personalizar los planes de tratamiento y, de manera potencial, prevenir algunas enfermedades por completo. Para los consumidores, proporcionarán mejores herramientas para la autogestión y la toma de decisiones compartida.

¿Qué es un orquestador de IA?
En el contexto de la IA generativa, un orquestador es como un director digital que ayuda a coordinar múltiples pasos para lograr una tarea compleja. En el sector sanitario, el papel de la orquestación es crucial dado lo mucho que está en juego en cada decisión. Nuestro orquestador se encuentra por encima de los modelos de lenguaje subyacentes y se asegura de que cada punto para obtener un diagnóstico se maneje de manera sistemática, lo que reduce el riesgo de errores en el futuro y ofrece la estabilidad, la coherencia y la transparencia necesarias para generar confianza en los usuarios.

¿Por qué se han fijado en los costes?
En un inicio, queríamos entender si la IA sólo solicitaba pruebas diagnósticas excesivas para llegar al diagnóstico correcto. Lo que descubrimos fue que nuestro orquestador fue capaz de llegar a la respuesta correcta con mucho menos dinero gastado en pruebas. En cierto modo, esto no es una sorpresa, ya que se reconoce que el exceso de pruebas diagnósticas es un desafío generalizado, lo que representa millones de pruebas innecesarias al año en los EE. UU. Este trabajo sugiere que la IA crea una oportunidad para que los médicos, y los consumidores, lleguen a un diagnóstico más rápido y preciso, al tiempo que reducen los costos.

The post El camino hacia la superinteligencia médica appeared first on Source LATAM.
 

​The post El camino hacia la superinteligencia médica appeared first on Source LATAM.  
Publicado el — Deja un comentario

Amazon Q Developer Java upgrade transformation CLI is now generally available

We would like to announce the general availability of Amazon Q Developer Java upgrade transformation CLI (command line interface). Using the CLI, customers can invoke Q Developer’s transformation capabilities from the command line and perform Java upgrades at scale.

The following capabilities are available:

  • Java application upgrades from source versions 8, 11, 17, or 21 to target versions 17 or 21 (now available in CLI in addition to IDE)
  • Selective transformation with options to choose steps from transformation plans, and libraries and versions to upgrade
  • The ability to convert embedded SQL to complete Oracle-to-PostgreSQL database migration with AWS Database Migration Service (AWS DMS)

With this launch, the capabilities are now available in the AWS Regions US East (N. Virginia) and Europe (Frankfurt). They can be accessed in the command line, on Linux and Mac OS. For more details, please visit the documentation page.


​We would like to announce the general availability of Amazon Q Developer Java upgrade transformation CLI (command line interface). Using the CLI, customers can invoke Q Developer’s transformation capabilities from the command line and perform Java upgrades at scale. The following capabilities are available:

Java application upgrades from source versions 8, 11, 17, or 21 to target versions 17 or 21 (now available in CLI in addition to IDE)
Selective transformation with options to choose steps from transformation plans, and libraries and versions to upgrade
The ability to convert embedded SQL to complete Oracle-to-PostgreSQL database migration with AWS Database Migration Service (AWS DMS)

With this launch, the capabilities are now available in the AWS Regions US East (N. Virginia) and Europe (Frankfurt). They can be accessed in the command line, on Linux and Mac OS. For more details, please visit the documentation page.  

Publicado el — Deja un comentario

AWS HealthOmics announces automatic input parameter interpolation for Nextflow workflows

Today, AWS HealthOmics introduces automatic interpolation of input parameters for Nextflow private workflows, eliminating the need for manual parameter template creation. This enhancement intelligently identifies and extracts both required and optional input parameters directly from workflow definitions, along with their descriptions. AWS HealthOmics is a HIPAA-eligible service that helps healthcare and life sciences customers accelerate scientific breakthroughs with fully managed biological data stores and workflows.

With this new feature, customers can launch bioinformatics workflows more quickly since they no longer need to manually identify, define, and validate each workflow parameter. This also helps reduce configuration errors that can occur when parameters are incorrectly specified or omitted. For specialized requirements, customers can still provide custom parameter templates to override the automatically generated configurations.

Input parameter interpolation for Nextflow workflows is now supported in all regions where AWS HealthOmics is available: US East (N. Virginia), US West (Oregon), Europe (Frankfurt, Ireland, London), Asia Pacific (Singapore), and Israel (Tel Aviv). Automatic parameter interpolation is already supported for WDL and CWL workflows today.

To learn more about automatic parameter interpolation and how to build private workflows, see the AWS HealthOmics documentation.


​Today, AWS HealthOmics introduces automatic interpolation of input parameters for Nextflow private workflows, eliminating the need for manual parameter template creation. This enhancement intelligently identifies and extracts both required and optional input parameters directly from workflow definitions, along with their descriptions. AWS HealthOmics is a HIPAA-eligible service that helps healthcare and life sciences customers accelerate scientific breakthroughs with fully managed biological data stores and workflows. With this new feature, customers can launch bioinformatics workflows more quickly since they no longer need to manually identify, define, and validate each workflow parameter. This also helps reduce configuration errors that can occur when parameters are incorrectly specified or omitted. For specialized requirements, customers can still provide custom parameter templates to override the automatically generated configurations. Input parameter interpolation for Nextflow workflows is now supported in all regions where AWS HealthOmics is available: US East (N. Virginia), US West (Oregon), Europe (Frankfurt, Ireland, London), Asia Pacific (Singapore), and Israel (Tel Aviv). Automatic parameter interpolation is already supported for WDL and CWL workflows today. To learn more about automatic parameter interpolation and how to build private workflows, see the AWS HealthOmics documentation.    

Publicado el — Deja un comentario

Amazon Route 53 launches capacity utilization metric for Resolver endpoints

Starting today, you can enable Amazon CloudWatch metric (ResolverEndpointCapacityStatus) to monitor the status of the query capacity for Elastic Network Interfaces (ENIs) associated with your Route 53 Resolver endpoint in Amazon Virtual Private Cloud (VPC). The new metric enables you to quickly view whether the Resolver endpoint is at the risk of meeting the service limit for query capacity, and take remediation steps like instantiating additional ENIs to meet the capacity needs.

Before today, you could enable CloudWatch to monitor the number of DNS queries that were forwarded by Route 53 Resolver endpoints, over a default five-minute interval, and make further estimations on when your endpoints will meet the query limits. With this launch, you can now enable the new metric to get direct alerts on the current status of your Resolver endpoint capacity, without requiring you to make additional estimations for calculating capacity of each endpoint. The status is reported for each Resolver endpoint, indicating whether the endpoint is operating within the normal capacity limit (0 – OK), has at least one ENI exceeding 50% capacity utilization (1 – Warning), or has at least one ENI exceeding 75% capacity utilization (2 – Critical). The new metric simplifies capacity management for Route 53 Resolver endpoints by providing clear, actionable signals for scaling decisions, without requiring additional analysis on the query volume.

To learn more about the launch, read the documentation or visit the Route 53 Resolver page. There is no charge for the metric, although you will incur charges for usage of Resolver endpoints.


​Starting today, you can enable Amazon CloudWatch metric (ResolverEndpointCapacityStatus) to monitor the status of the query capacity for Elastic Network Interfaces (ENIs) associated with your Route 53 Resolver endpoint in Amazon Virtual Private Cloud (VPC). The new metric enables you to quickly view whether the Resolver endpoint is at the risk of meeting the service limit for query capacity, and take remediation steps like instantiating additional ENIs to meet the capacity needs.
Before today, you could enable CloudWatch to monitor the number of DNS queries that were forwarded by Route 53 Resolver endpoints, over a default five-minute interval, and make further estimations on when your endpoints will meet the query limits. With this launch, you can now enable the new metric to get direct alerts on the current status of your Resolver endpoint capacity, without requiring you to make additional estimations for calculating capacity of each endpoint. The status is reported for each Resolver endpoint, indicating whether the endpoint is operating within the normal capacity limit (0 – OK), has at least one ENI exceeding 50% capacity utilization (1 – Warning), or has at least one ENI exceeding 75% capacity utilization (2 – Critical). The new metric simplifies capacity management for Route 53 Resolver endpoints by providing clear, actionable signals for scaling decisions, without requiring additional analysis on the query volume. To learn more about the launch, read the documentation or visit the Route 53 Resolver page. There is no charge for the metric, although you will incur charges for usage of Resolver endpoints.  

Publicado el — Deja un comentario

Amazon EC2 C7i instances are now available in the Middle East (UAE) Region

Starting today, Amazon Elastic Compute Cloud (Amazon EC2) C7i instances powered by custom 4th Gen Intel Xeon Scalable processors (code-named Sapphire Rapids) are available in the Middle East (UAE) Region. C7i instances are supported by custom Intel processors, available only on AWS, and offer up to 15% better performance over comparable x86-based Intel processors utilized by other cloud providers.

C7i instances deliver up to 15% better price-performance versus C6i instances and are a great choice for all compute-intensive workloads, such as batch processing, distributed analytics, ad-serving, and video encoding. C7i instances offer larger instance sizes, up to 48xlarge, and two bare metal sizes (metal-24xl, metal-48xl). These bare-metal sizes support built-in Intel accelerators: Data Streaming Accelerator, In-Memory Analytics Accelerator, and QuickAssist Technology that are used to facilitate efficient offload and acceleration of data operations and optimize performance for workloads.

C7i instances support new Intel Advanced Matrix Extensions (AMX) that accelerate matrix multiplication operations for applications such as CPU-based ML. Customers can attach up to 128 EBS volumes to a C7i instance vs. up to 28 EBS volumes to a C6i instance. This allows processing of larger amounts of data, scale workloads, and improved performance over C6i instances.

To learn more, visit Amazon EC2 C7i Instances. To get started, see the AWS Management Console.


​Starting today, Amazon Elastic Compute Cloud (Amazon EC2) C7i instances powered by custom 4th Gen Intel Xeon Scalable processors (code-named Sapphire Rapids) are available in the Middle East (UAE) Region. C7i instances are supported by custom Intel processors, available only on AWS, and offer up to 15% better performance over comparable x86-based Intel processors utilized by other cloud providers.
C7i instances deliver up to 15% better price-performance versus C6i instances and are a great choice for all compute-intensive workloads, such as batch processing, distributed analytics, ad-serving, and video encoding. C7i instances offer larger instance sizes, up to 48xlarge, and two bare metal sizes (metal-24xl, metal-48xl). These bare-metal sizes support built-in Intel accelerators: Data Streaming Accelerator, In-Memory Analytics Accelerator, and QuickAssist Technology that are used to facilitate efficient offload and acceleration of data operations and optimize performance for workloads. C7i instances support new Intel Advanced Matrix Extensions (AMX) that accelerate matrix multiplication operations for applications such as CPU-based ML. Customers can attach up to 128 EBS volumes to a C7i instance vs. up to 28 EBS volumes to a C6i instance. This allows processing of larger amounts of data, scale workloads, and improved performance over C6i instances. To learn more, visit Amazon EC2 C7i Instances. To get started, see the AWS Management Console.  

Publicado el — Deja un comentario

Research and Engineering Studio on AWS Version 2025.06 now available

Today we announce Research and Engineering Studio (RES) on AWS Version 2025.06, which introduces significant improvements to instance bootstrapping, security configurations, and logging capabilities. This release streamlines the RES deployment process, enhances security controls for infrastructure hosts, adds Amazon CloudWatch logging for virtual desktop instances (VDI), and provides new customization options.

RES 2025.06 features a streamlined bootstrapping process that accelerates infrastructure and VDI launch times. The improved process also enables customers to create RES-ready Amazon Machine Images (AMIs) without requiring an active RES deployment, making it easier to apply patches and customizations. Enhanced security configurations for infrastructure hosts now have more granular permissions, helping reduce security risks from compromised hosts. Additionally, a new Amazon CloudWatch Logs integration, enabled by default, centralizes VDI logs to simplify troubleshooting and monitoring.

RES 2025.06 adds support for Amazon Linux 2023 for both infrastructure hosts and VDIs, while also introducing support for Rocky Linux 9 for VDIs. Customers can now specify prefixes on the AWS Identity and Access Management (IAM) roles used by RES, providing greater control over IAM resource naming conventions. The release also introduces the ability to delete or remove mounted file systems directly from the RES user interface, simplifying storage management. Furthermore, RES 2025.06 expands regional availability to include AWS GovCloud (US-East), offering an additional deployment option for government customers.

To learn more about RES 2025.06, including detailed release notes and deployment instructions, visit the Research and Engineering Studio documentation. You can also consult the RES GitHub repository for additional technical information.


​Today we announce Research and Engineering Studio (RES) on AWS Version 2025.06, which introduces significant improvements to instance bootstrapping, security configurations, and logging capabilities. This release streamlines the RES deployment process, enhances security controls for infrastructure hosts, adds Amazon CloudWatch logging for virtual desktop instances (VDI), and provides new customization options. RES 2025.06 features a streamlined bootstrapping process that accelerates infrastructure and VDI launch times. The improved process also enables customers to create RES-ready Amazon Machine Images (AMIs) without requiring an active RES deployment, making it easier to apply patches and customizations. Enhanced security configurations for infrastructure hosts now have more granular permissions, helping reduce security risks from compromised hosts. Additionally, a new Amazon CloudWatch Logs integration, enabled by default, centralizes VDI logs to simplify troubleshooting and monitoring. RES 2025.06 adds support for Amazon Linux 2023 for both infrastructure hosts and VDIs, while also introducing support for Rocky Linux 9 for VDIs. Customers can now specify prefixes on the AWS Identity and Access Management (IAM) roles used by RES, providing greater control over IAM resource naming conventions. The release also introduces the ability to delete or remove mounted file systems directly from the RES user interface, simplifying storage management. Furthermore, RES 2025.06 expands regional availability to include AWS GovCloud (US-East), offering an additional deployment option for government customers. To learn more about RES 2025.06, including detailed release notes and deployment instructions, visit the Research and Engineering Studio documentation. You can also consult the RES GitHub repository for additional technical information.  

Publicado el — Deja un comentario

AWS Firewall Manager provides support for AWS WAF L7 DDOS managed rules

AWS Firewall Manager announces security policy support for enhanced application layer (L7) DDoS protection within AWS WAF. The application layer (L7) DDoS protection is an AWS Managed Rule group that automatically detects and mitigates DDoS events of any applications on Amazon CloudFront, Application Load Balancer (ALB) and other AWS services supported by WAF. AWS Firewall Manager helps cloud security administrators and site reliability engineers protect applications while reducing the operational overhead of manually configuring and managing rules.

Working with AWS Firewall Manager, customers can provide defense in depth policies to address the full range of web site protections from the newly released AWS WAF (L7) DDoS protections to non-HTTP based threats to web site infrastructure. By looking at the totality of a web-sites’ technology stack, customers can define and deploy all the needed protections.

AWS Firewall Manager support for application layer (L7) DDoS protection can be enabled for all AWS WAF and AWS Shield users. Customers can add this specialized Amazon Managed Rule set to a new or existing AWS Firewall Manager policy. AWS Firewall Manager supports this Amazon Managed Rule set in all regions where WAF offers the feature which means all Advanced subscribers in all supported AWS Regions, except Asia Pacific (Thailand), Mexico (Central), and China (Beijing and Ningxia). You can deploy this AWS Managed Rule group for your Amazon CloudFront, ALB, and other supported AWS resources.

To learn more about how AWS Firewall Manager works with WAF’s new Managed Rules, see the AWS Firewall Manager documentation for more details and the AWS Region Table for the list of regions where AWS Firewall Manager is currently available. To learn more about AWS Firewall Manager, its features, and its pricing, visit the AWS Firewall Manager website.


​AWS Firewall Manager announces security policy support for enhanced application layer (L7) DDoS protection within AWS WAF. The application layer (L7) DDoS protection is an AWS Managed Rule group that automatically detects and mitigates DDoS events of any applications on Amazon CloudFront, Application Load Balancer (ALB) and other AWS services supported by WAF. AWS Firewall Manager helps cloud security administrators and site reliability engineers protect applications while reducing the operational overhead of manually configuring and managing rules. Working with AWS Firewall Manager, customers can provide defense in depth policies to address the full range of web site protections from the newly released AWS WAF (L7) DDoS protections to non-HTTP based threats to web site infrastructure. By looking at the totality of a web-sites’ technology stack, customers can define and deploy all the needed protections. AWS Firewall Manager support for application layer (L7) DDoS protection can be enabled for all AWS WAF and AWS Shield users. Customers can add this specialized Amazon Managed Rule set to a new or existing AWS Firewall Manager policy. AWS Firewall Manager supports this Amazon Managed Rule set in all regions where WAF offers the feature which means all Advanced subscribers in all supported AWS Regions, except Asia Pacific (Thailand), Mexico (Central), and China (Beijing and Ningxia). You can deploy this AWS Managed Rule group for your Amazon CloudFront, ALB, and other supported AWS resources. To learn more about how AWS Firewall Manager works with WAF’s new Managed Rules, see the AWS Firewall Manager documentation for more details and the AWS Region Table for the list of regions where AWS Firewall Manager is currently available. To learn more about AWS Firewall Manager, its features, and its pricing, visit the AWS Firewall Manager website.    

Publicado el — Deja un comentario

Amazon EC2 I7ie instances are now available in additional AWS regions

Amazon Web Services (AWS) announces the availability of Amazon EC2 I7ie instances in the AWS Asia Pacific (Sydney), Asia Pacific (Malaysia) and AWS GovCloud (US-East) Regions. Designed for large storage I/O intensive workloads, these new instances are powered by 5th generation Intel Xeon Scalable processors with an all-core turbo frequency of 3.2 GHz, offering up to 40% better compute performance and 20% better price performance over existing I3en instances.

I7ie instances offer up to 120TB local NVMe storage density—the highest available in the cloud for storage optimized instances—and deliver up to twice as many vCPUs and memory compared to prior generation instances. Powered by 3rd generation AWS Nitro SSDs, these instances achieve up to 65% better real-time storage performance, up to 50% lower storage I/O latency, and 65% lower storage I/O latency variability compared to existing I3en instances. Additionally, the 16KB torn write prevention feature, enables customers to eliminate performance bottlenecks for database workloads.

I7ie instances are high-density storage-optimized instances, for workloads that demand rapid local storage with high random read/write performance and consistently low latency for accessing large data sets. These instances are offered in eleven different sizes including 2 metal sizes, providing flexibility for customers computational needs. They deliver up to 100 Gbps of network performance bandwidth, and 60 Gbps of dedicated bandwidth for Amazon Elastic Block Store (EBS), ensuring fast and efficient data transfer for applications.

To learn more, visit the I7ie instances page.


​Amazon Web Services (AWS) announces the availability of Amazon EC2 I7ie instances in the AWS Asia Pacific (Sydney), Asia Pacific (Malaysia) and AWS GovCloud (US-East) Regions. Designed for large storage I/O intensive workloads, these new instances are powered by 5th generation Intel Xeon Scalable processors with an all-core turbo frequency of 3.2 GHz, offering up to 40% better compute performance and 20% better price performance over existing I3en instances. I7ie instances offer up to 120TB local NVMe storage density—the highest available in the cloud for storage optimized instances—and deliver up to twice as many vCPUs and memory compared to prior generation instances. Powered by 3rd generation AWS Nitro SSDs, these instances achieve up to 65% better real-time storage performance, up to 50% lower storage I/O latency, and 65% lower storage I/O latency variability compared to existing I3en instances. Additionally, the 16KB torn write prevention feature, enables customers to eliminate performance bottlenecks for database workloads. I7ie instances are high-density storage-optimized instances, for workloads that demand rapid local storage with high random read/write performance and consistently low latency for accessing large data sets. These instances are offered in eleven different sizes including 2 metal sizes, providing flexibility for customers computational needs. They deliver up to 100 Gbps of network performance bandwidth, and 60 Gbps of dedicated bandwidth for Amazon Elastic Block Store (EBS), ensuring fast and efficient data transfer for applications. To learn more, visit the I7ie instances page.  

Publicado el — Deja un comentario

Del prompt a la reproducción con Sora de Azure OpenAI en Azure AI Foundry

junio 27, 2025

Del prompt a la reproducción con Sora de Azure OpenAI en Azure AI Foundry

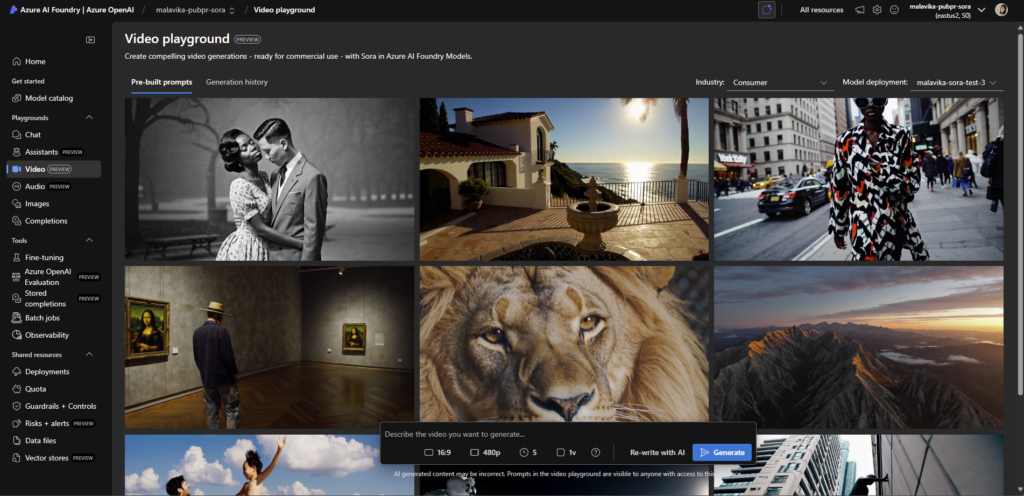
Captura de pantalla del área de juego de video de Sora en Azure AI Foundry

Por: Thasmika Gokal , directora sénior de productos de Azure AI Foundry.

Presentamos Sora y el área de juegos de vídeo en Azure AI Foundry

El área de juegos de vídeo de Azure AI Foundry es el banco de pruebas de alta fidelidad para la creación de prototipos con modelos de generación de vídeo de última generación, como Sora de Azure AI Foundry Models, listos para uso comercial. Lean nuestro blog de lanzamiento de la comunidad tecnológica sobre gpt-image-1 y Sora.

El desarrollo moderno implica trabajar en varios sistemas (API, servicios, SDK y modelos de datos), a menudo antes de estar listos para comprometerse por completo con un marco, escribir pruebas o poner en marcha la infraestructura. A medida que aumenta la complejidad de los ecosistemas de software, la necesidad de entornos seguros y ligeros para validar las ideas se vuelve crítica. El parque infantil de video se construyó para satisfacer esta necesidad.

Diseñado en específico para desarrolladores, Video Playground ofrece un entorno controlado para experimentar con estructuras de solicitudes, evaluar la coherencia del modelo en relación con el cumplimiento de solicitudes y optimizar los resultados para casos de uso de la industria. Ya sea que estén involucrados en la creación de productos o herramientas de video nativos de IA o en la transformación de los flujos de trabajo de su empresa, Video Playground mejora su planificación y experimentación, para que puedan iterar más rápido, eliminar el riesgo de sus flujos de trabajo y enviar con confianza.

Captura de pantalla del área de juego de video de Sora en Azure AI Foundry

Prototipado rápido desde el prompt hasta la reproducción y el código

Video Playground ofrece un entorno de configuración bajo demanda y de baja fricción diseñado para la creación rápida de prototipos, la exploración de API y la validación técnica con modelos de generación de vídeo. Piensen en el área de juegos de video como su entorno de creación de prototipos de alta fidelidad, creado para ayudarlos a crear mejor, más rápido y de manera más inteligente, sin configuración de localhost, importar dependencias en conflicto o preocuparse por la compatibilidad entre la compilación y el modelo.​

Sora de Azure OpenAI es la primera versión para el área de juegos de video, y el modelo viene con su propia API, una oferta única disponible para los usuarios de Azure AI Foundry. El uso de la API en VS Code permite el desarrollo a escala en el entorno de VS Code para su caso de uso una vez que se realiza la experimentación inicial en el área de juegos de vídeo.

  • Iterar más rápido: Experimenten con prompts de texto y ajusten los controles de generación, como la relación de aspecto, la resolución y la duración.
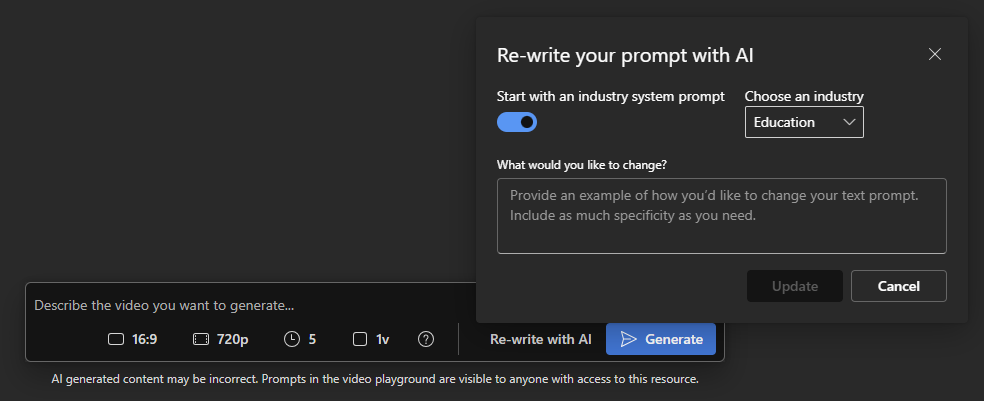
  • Optimización de solicitudes: depuren, ajusten y reescriban la sintaxis de los prompts con IA, comparen a nivel visual  los resultados de las variaciones con las que está probando, utilicen los prompts prediseñados del sector y creen sus propias variaciones de solicitudes disponibles en el patio de recreo, basadas en el comportamiento del modelo.
  • Interfaz coherente para la API: Todo en el área de juegos de video refleja la estructura de la API del modelo, por lo que lo que funciona aquí se traduce directo en código, con previsibilidad y repetibilidad.
Captura de pantalla del entorno de la creación de video

Funciones

Creamos un área de juegos de video para desarrolladores que desean experimentar con la generación de video. Esta área es un entorno controlado con todas las funciones para experimentos de alta fidelidad diseñado para API específicas del modelo, y una excelente interfaz de demostración para su director de productos y vicepresidente de ingeniería.

  • Controles de generación específicos del modelo: ajusten los controles clave (por ejemplo, relación de aspecto, duración, resolución) para comprender en profundidad la capacidad de respuesta y las restricciones específicas del modelo.
  • Prompts prediseñados: Tomen inspiración sobre cómo pueden usar modelos de generación de video como Sora para su caso de uso. En la pestaña de prompts prediseñados, hay un conjunto de 9 videos seleccionados por Microsoft.
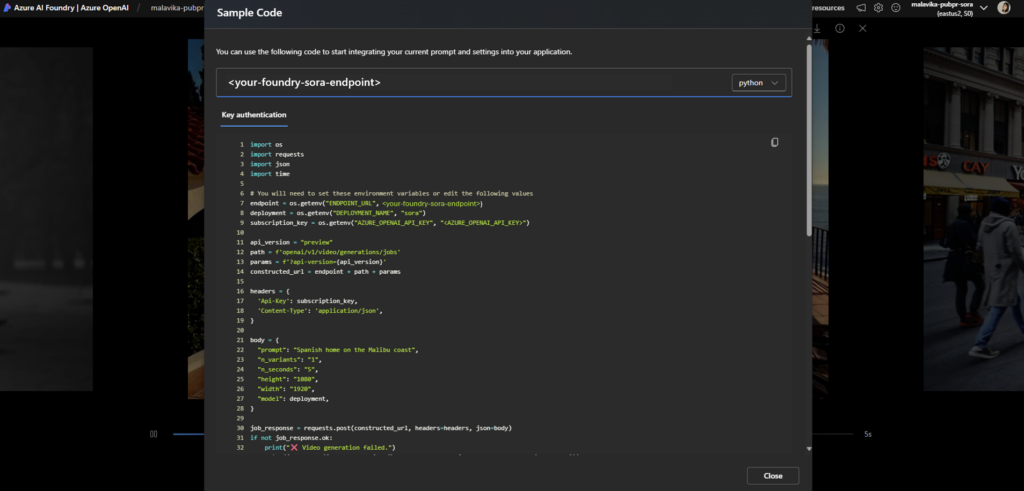
  • Migración a producción con ejemplos de código multilingüe: en el caso de Sora de Azure OpenAI, esto refleja la API de Sora, una oferta única disponible para los usuarios de Azure AI Foundry. Uso de los ejemplos de código multilingüe «Ver código» (Python, JavaScript, GO, cURL) para la salida de vídeo, las solicitudes y los controles de generación que reflejan la estructura de la API. Lo que se crea en el área de juegos de vídeo se puede portar de manera fácil a VS Code para que puedan continuar el desarrollo escalado en VS Code con la API.
  • Observaciones en paralelo en la vista de cuadrícula: observen de manera visual los resultados a través de ajustes de prompt o cambios de parámetros.
  • Integración de Azure AI Content Safety: con todos los puntos de conexión del modelo integrados con Azure AI Content Safety, se filtran los vídeos dañinos e inseguros.

Vean una demostración de estas características y Sora en el área de juegos de video en nuestra sesión de trabajo dedicada en Microsoft Build 2025 aquí.

Captura de pantalla de un código muestra de la creación de video en Azure AI Foundry

No es necesario encontrar, crear o configurar una interfaz de usuario personalizada para localhost para la generación de vídeo, esperar que funcione en automático para el próximo modelo de última generación o dedicar tiempo a resolver errores de compilación en cascada debido a paquetes o cambios de código necesarios para los nuevos modelos. El área de juegos de vídeo de Azure AI Foundry les proporciona acceso según las versiones. Compilen con los modelos más recientes con actualizaciones de API mostradas en una interfaz de usuario coherente.

Qué probar en el área de juegos de video

Al usar el área de juegos de vídeo, al planificar la carga de trabajo de producción, tengan en cuenta lo siguiente a medida que evalúa de manera visual sus generaciones:

  1. Traducción de prompt a movimiento
    • ¿El modelo de vídeo interpreta mi prompt de una manera que tenga sentido lógico y temporal?
    • ¿Es el movimiento coherente con la acción o escena descrita? ¿Cómo podría usar Reescribir con IA para mejorar mi prompt?
  2. Consistencia de fotogramas
    • ¿Los caracteres, objetos y estilos se mantienen coherentes en todos los fotogramas?
    • ¿Hay artefactos visuales, fluctuaciones o transiciones antinaturales?
  3. Control de escena
    • ¿Qué tan bien puedo controlar la composición de la escena, el comportamiento del sujeto o los ángulos de la cámara?
    • ¿Puedo guiar transiciones de escena o entornos de fondo?
  4. Duración y tiempo
    • ¿Cómo afectan las diferentes estructuras de prompts a la duración y el ritmo del vídeo?
    • ¿El video se siente demasiado rápido, demasiado lento o demasiado corto?
  5. Integración de entrada multimodal
    • ¿Qué sucede cuando proporciono una imagen de referencia, datos de pose o entrada de audio?
    • ¿Puedo generar vídeo con sincronización de labios con una voz en off determinada?
  6. Necesidades de posprocesamiento
    • ¿Qué nivel de fidelidad bruta puedo esperar antes de necesitar herramientas de edición?
    • ¿Necesito mejorar, estabilizar o retocar el video antes de usarlo en producción?
  7. Latencia y rendimiento
    • ¿Cuánto tiempo se tarda en generar vídeo para diferentes tipos de prompts o resoluciones?
    • ¿Cuál es la relación costo-rendimiento de generar clips de 5 segundos frente a 15 segundos?

Ejecuten Sora y otros modelos a escala con Azure AI Foundry, sin necesidad de infraestructura. Obtengan más información en nuestro reciente video de Microsoft Mechanics que comparte más sobre la API de Sora en acción:

Empiecen ahora

  1. Inicien sesión o regístrense en Azure AI Foundry.
  2. Creen un centro y/o proyecto de Foundry.
  3. Cree una implementación de modelo para Azure OpenAI Sora desde el catálogo de modelos de Foundry o directo desde el área de juegos de vídeo.
  4. Prototipo en el área de juegos de video; iteren sobre los prompts de texto y optimicen los controles de generación para su caso de uso.
  5. ¿Prototipo hecho? Cambien al desarrollo escalado en VS Code con Sora desde la API de Azure OpenAI.

Creación con Azure AI Foundry

The post Del prompt a la reproducción con Sora de Azure OpenAI en Azure AI Foundry appeared first on Source LATAM.


​The post Del prompt a la reproducción con Sora de Azure OpenAI en Azure AI Foundry appeared first on Source LATAM.  

Publicado el — Deja un comentario

Amazon Braket adds dynamic circuit capabilities on IQM Garnet

Today, Amazon Braket introduced experimental support for dynamic circuits on IQM’s Garnet quantum processing unit (QPU). This capability enables mid-circuit measurements (MCM) and feed-forward operations, allowing quantum researchers and developers to implement more advanced quantum algorithms. Dynamic circuits are a key building block for quantum error mitigation and correction. They can improve resource efficiency via qubit reuse, as well as enable experimentation with algorithms and protocols that require conditional logic.

With dynamic circuits, customers can now perform active qubit reset to reuse qubits within a single circuit execution and apply conditional operations based on measurement outcomes. These techniques can reduce circuit depth requirements unlocking new capabilities on Amazon Braket.

To use dynamic circuits, customers can submit verbatim programs that include mid-circuit measurement and conditional rotation instructions. These programs can be written using using OpenQASM, the Amazon Braket SDK, or the Amazon Braket Qiskit Provider. This experimental capability is available to all customers using an IQM device in the Europe (Stockholm) Region without requiring any special access permissions.

For more information, visit our Experimental Capabilities documentation page and read our launch blog post.


​Today, Amazon Braket introduced experimental support for dynamic circuits on IQM’s Garnet quantum processing unit (QPU). This capability enables mid-circuit measurements (MCM) and feed-forward operations, allowing quantum researchers and developers to implement more advanced quantum algorithms. Dynamic circuits are a key building block for quantum error mitigation and correction. They can improve resource efficiency via qubit reuse, as well as enable experimentation with algorithms and protocols that require conditional logic. With dynamic circuits, customers can now perform active qubit reset to reuse qubits within a single circuit execution and apply conditional operations based on measurement outcomes. These techniques can reduce circuit depth requirements unlocking new capabilities on Amazon Braket. To use dynamic circuits, customers can submit verbatim programs that include mid-circuit measurement and conditional rotation instructions. These programs can be written using using OpenQASM, the Amazon Braket SDK, or the Amazon Braket Qiskit Provider. This experimental capability is available to all customers using an IQM device in the Europe (Stockholm) Region without requiring any special access permissions. For more information, visit our Experimental Capabilities documentation page and read our launch blog post.